March Code
Traducción y localización

Polyglot: plataforma con IA para una agencia de traducción en la que la IA nunca ve datos personales

Cómo usar modelos de IA en la nube de forma legal con documentos que contienen pasaportes, expedientes judiciales y datos médicos: los datos personales se sustituyen por máscaras en el propio servidor del cliente, a la nube solo llega texto anonimizado y un segundo modelo de IA revisa cada traducción automática, mientras la responsabilidad sobre la calidad sigue siendo de una persona. Hecho para una agencia de traducción de la UE: 9 etapas desde la subida del escaneo hasta la entrega con firma electrónica, 24 idiomas y 1,5 millones de segmentos traducidos en la memoria de traducción.

Cliente: Agencia de traducción, Unión Europea (Letonia)IASaaSAutomatización
Polyglot: plataforma con IA para una agencia de traducción en la que la IA nunca ve datos personales

0

datos personales en la nube: la IA solo ve máscaras

4 de 209

segmentos que lee el revisor tras la doble revisión con IA

1 minuto

para crear un pedido en lugar de montarlo a partir de correos

2–3 meses

de la especificación al uso en producción

01

Reto

Nuestro cliente es una agencia de traducción de la UE (Riga, Letonia). Trabaja para organismos públicos y grandes empresas: cientos de pedidos al mes, 24 idiomas y documentos con categorías especiales de datos personales, como pasaportes, expedientes judiciales e informes médicos. El trabajo se rige por la ISO 17100, la norma europea de servicios de traducción, y por el RGPD. Mandar a la nube tal cual un archivo con el pasaporte de alguien supone arriesgarse a una multa de hasta el 4% de la facturación anual y a perder el acceso a los contratos públicos.

Las herramientas habituales de la agencia (correo, Excel y el software de traducción memoQ) dejan de funcionar con estos volúmenes:

  • Los gestores de proyectos se ahogan en tareas rutinarias. Cada pedido se monta a mano a partir de correos: archivos, tarifas, plazos y la búsqueda de un traductor libre.
  • Los archivos con datos personales llegan sin protección a colaboradores externos y a servicios en la nube. Al regulador le da igual que «todo el mundo lo haga»: la responsable es la agencia.
  • Los precios se calculan a mano con tablas de descuentos, y los errores van en las dos direcciones: o el trabajo sale a pérdidas, o el cliente discute una factura inflada.
  • Para saber «quién aprobó qué» hay que reconstruir hilos de correo. Si surge una disputa por la calidad o los plazos, no hay pruebas.

«Conectar ChatGPT» sin más no era una opción. Ningún cliente serio se fía de una traducción automática sin una revisión independiente, y ningún abogado dará el visto bueno a enviar datos de pasaportes en claro a una IA en la nube: toda la responsabilidad recaería en la agencia. La agencia necesitaba un sistema en el que la IA acelerase cada etapa, una persona respondiera de la calidad y los datos personales nunca salieran del servidor de la empresa.

¿Tu empresa no es una agencia de traducción? Da igual: si manejas datos sanitarios, jurídicos, financieros o de RR. HH., la protección de datos te plantea exactamente el mismo problema. A continuación te contamos cómo lo resolvimos.

Las capturas son de un entorno de demostración: los proyectos, clientes, nombres y documentos son datos de prueba.

02

Solución

Un único flujo en lugar de correo, memoQ y Excel

Polyglot lleva cada documento por nueve etapas, desde la subida del escaneo hasta un paquete con firma electrónica. El sistema reconoce los escaneos, divide el texto en segmentos, rellena las traducciones que ya existen a partir de la memoria acumulada, envía el texto nuevo a un modelo de IA, hace que un segundo modelo lo revise, y una persona aprueba el resultado. En cada etapa ves dónde está el documento, quién se encarga de él y qué está pendiente de una decisión.

Tres espacios de trabajo, tres quebraderos de cabeza menos

Gestor de proyectos
Toda la producción en una pantalla
  • Crear un pedido lleva un minuto: el sistema elige la memoria de traducción, los glosarios y los traductores para el par de idiomas
  • Una única cola de decisiones agrupada por proyecto, para que nada se pierda en el correo
  • Ves qué está a punto de vencer, qué va con retraso y qué está esperando al cliente
Traductor
Ofertas de trabajo justas y un editor cómodo
  • Cada oferta muestra la tarifa, el volumen y el plazo antes de aceptarla: el primero que acepta se queda el trabajo
  • Un espacio de trabajo en el navegador: memoria de traducción, glosarios, sugerencias y comentarios del equipo
  • Un panel de ingresos con exportación para facturar: el total del mes se suma solo
Revisor interno
Control de calidad según la ISO 17100
  • El escaneo reconocido se revisa antes de empezar a traducir, así que la basura nunca entra en el flujo
  • Una aprobación final de la entrega con confirmación explícita
  • El principio de los cuatro ojos lo impone el servidor, no la confianza: el sistema no te deja cerrar la revisión de tu propio trabajo

Anonimización de datos personales: cómo traduce la IA pasaportes ajenos sin verlos

1. Máscaras en lugar de nombres, en el servidor de la agencia

El sistema localiza en el documento nombres, direcciones y números de pasaporte y de cuenta (incluidos formatos locales con dígitos de control) y los sustituye por máscaras antes de enviar nada a la nube

2. Traducción en la nube

Solo sale texto anonimizado. El modelo de IA lo traduce con los glosarios del cliente; la tabla de correspondencias de las máscaras está cifrada y nunca sale del servidor

3. Revisión por un segundo modelo de IA

Un segundo modelo, de otro proveedor, revisa la traducción del primero y marca los puntos dudosos con una corrección propuesta. El revisor trabaja sobre esas marcas en lugar de releerlo todo

4. Datos restaurados, documento entregado

Los valores reales vuelven al texto en el servidor de la agencia. El documento se reconstruye con su formato original: DOCX, PDF y un paquete de firma electrónica conforme al estándar de la UE

Qué más distingue a la plataforma

  • Precios justos sin cuentas a mano. Los descuentos por repeticiones se calculan solos: cuantas más coincidencias con la memoria de traducción acumulada, más barato le sale el pedido al cliente de la agencia. El sistema directamente no emite un presupuesto por debajo del mínimo acordado.
  • Años de traducciones, sin perder nada. Las bases creadas durante años de trabajo se migraron desde memoQ y Trados en un solo archivo: 1,5 millones de segmentos traducidos. Cada pedido entregado alimenta la memoria de su propio cliente, y las bases de clientes distintos nunca se mezclan.
  • IA bajo control y con precio conocido. Se sabe lo que cuesta cada llamada a la IA; el texto jurídico va a un modelo y el técnico, a otro. Si el proveedor de IA se cae, un modelo de reserva toma el relevo solo, y la nube se puede desactivar con un botón.
03

El sistema por dentro

Pantallas reales de un sistema en funcionamiento, no maquetas. Haz clic para verlas de cerca

Flujo de producción
El panel del gestor muestra toda la producción y todo lo que espera una decisión humana: qué revisar, a quién ofrecer un trabajo, qué entregar al cliente y qué va con retraso. Se acabaron las reuniones de seguimiento
Un pedido nuevo en un minuto: el sistema elige la memoria de traducción y los glosarios del cliente, detecta el tipo de documento y calcula el precio por adelantado
Cola de decisiones: todo lo pendiente de aprobación, agrupado por proyecto y con el tiempo que lleva esperando cada tarea. Una revisión solo se puede aprobar después de abrir el documento, porque el principio de los cuatro ojos lo impone el servidor, no la confianza
Capa de IA y protección de datos
Anonimización antes de la nube: los nombres, números de documento y direcciones se localizan y se enmascaran en el servidor de la agencia. A la derecha, todos los datos personales detectados; cualquier visualización de un valor real queda en el log de accesos
Traducción con IA y revisión independiente: la nube ve máscaras en lugar de datos personales. Un segundo modelo de IA revisa la traducción del primero y marca los puntos dudosos, aquí 4 marcas en 209 segmentos
Catálogo de modelos de IA con precios y enrutamiento: el texto jurídico va a un modelo y el técnico, a otro. El coste de cada llamada a la IA se registra en euros
Centro de protección de datos: un catálogo de detectores de datos personales por tipo e idioma, un modo «la nube no guarda nada» que se activa con un interruptor y un log de accesos completo
Editor y memoria de traducción
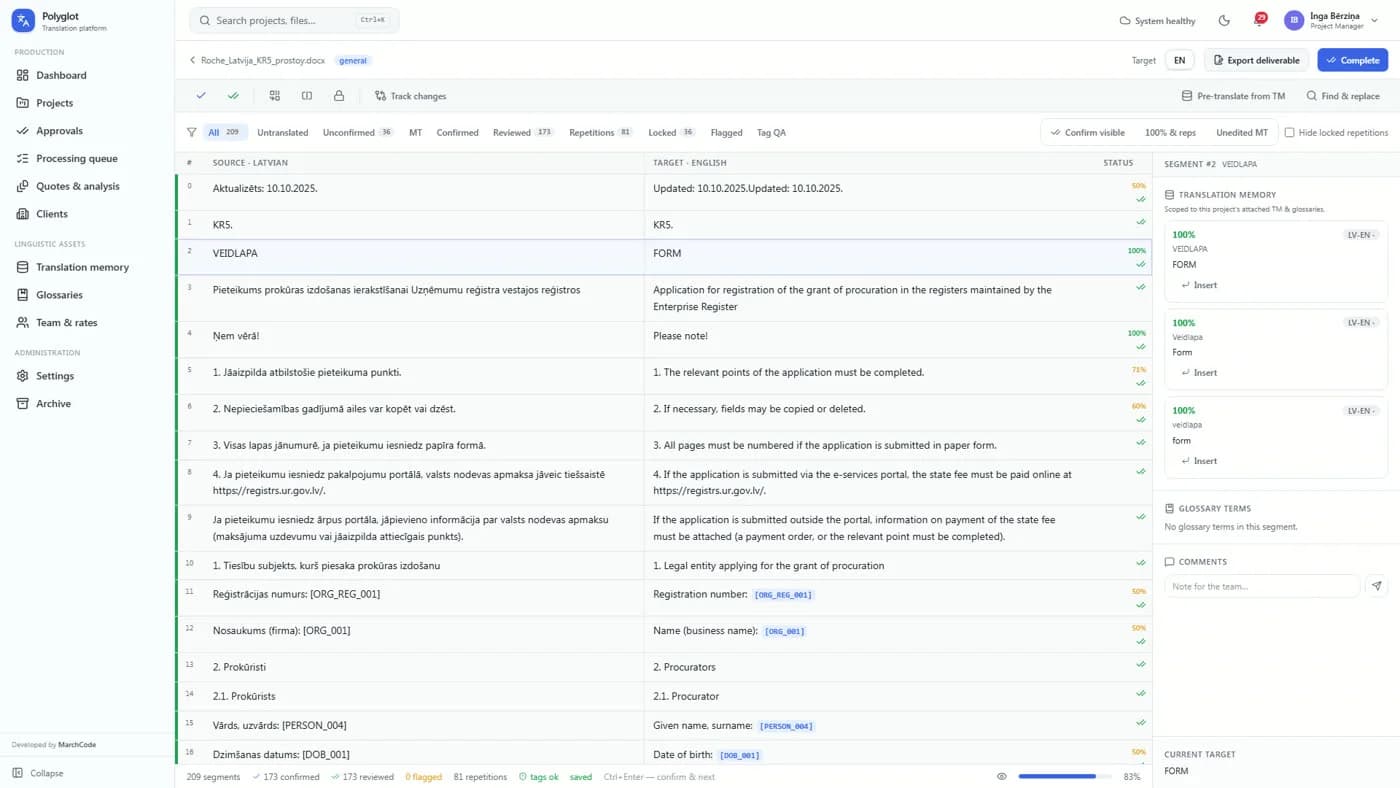
Espacio de trabajo del traductor (editor TAO): memoria de traducción, estados de los segmentos, etiquetas protegidas contra ediciones accidentales y comentarios del equipo. Todo en el navegador, sin instalar memoQ
Memoria de traducción: 1,5 millones de segmentos traducidos en 24 idiomas. Cada pedido entregado alimenta automáticamente la base de su cliente, y las bases de los clientes nunca se mezclan
Dinero y traductores
El precio se conoce antes de crear el pedido: descuentos por coincidencias con la memoria de traducción, cuatro formas de contar el volumen y lo que cobra el traductor. El sistema no emite un presupuesto por debajo del mínimo acordado
Panel del traductor: las ofertas de trabajo muestran la tarifa, el volumen y el plazo antes de aceptar. El primero que acepta se queda el trabajo; los ingresos y la exportación para facturar están en su área personal
04

Resultados

0

datos personales en la nube: la IA solo ve máscaras

Los nombres, direcciones y números de documento se sustituyen por máscaras en el servidor de la agencia antes de cualquier llamada al modelo de IA. Cada vez que se muestra un valor real, queda registrado en el log de accesos

4 de 209

segmentos que lee el revisor tras la doble revisión con IA

El primer modelo traduce; el segundo, de otro proveedor, lo revisa y marca los puntos dudosos. El revisor trabaja sobre esas marcas en lugar de releer todo el documento

1 minuto

para crear un pedido en lugar de montarlo a partir de correos

El sistema elige la memoria, los glosarios y los traductores para el par de idiomas y calcula el precio por adelantado. 24 idiomas, 1,5 millones de segmentos traducidos y las bases migradas desde memoQ y Trados en un solo archivo

2–3 meses

de la especificación al uso en producción

El núcleo (flujo, roles y espacio del traductor) entró en producción en 2–3 meses, y desde entonces mejora cada semana. Cada versión pasa antes 211 pruebas automáticas

05

Análisis en profundidad

Por qué importa este caso

  • Una IA de la que responde el sistema, no «el humor del modelo». Dos modelos se revisan entre sí, cada llamada tiene un coste conocido y, si un proveedor falla, un modelo de reserva toma el relevo automáticamente. El cliente sabe lo que cuesta cada pedido; los datos y el proceso son del cliente, no del proveedor de IA.
  • Datos sensibles, tratados en serio. Los documentos con categorías especiales de datos personales nunca salen en claro del servidor del cliente. La arquitectura se diseñó a partir de los requisitos del RGPD y de la ISO 17100, no se adaptó a ellos a posteriori.
  • Inmersión a fondo en el sector. Aprendimos cómo funciona la agencia hasta el último detalle, desde las tablas de descuentos del sector y el principio de los cuatro ojos hasta los requisitos de la administración para la firma electrónica. Así abordamos cualquier sector: primero el proceso, después el código.
  • Un sistema a medida frente a suscripciones. Reglas de precios propias, los datos de sus clientes en su propio hardware, independencia del proveedor de IA y nada de cuotas por usuario que crecen con cada nueva contratación.
  • Rapidez sin atajos. El cliente vio las primeras pantallas funcionando en pocas semanas, y el núcleo entró en producción en 2–3 meses. Cada versión pasa antes 211 pruebas automáticas, así que las actualizaciones no rompen el trabajo de la agencia.

La misma arquitectura para cualquier dato regulado

Cambia de sector y el problema le sonará igual a cualquiera que maneje historiales médicos, contratos, documentos judiciales o datos de RR. HH. A la nube no van datos personales, solo máscaras, así que no hay transferencia internacional de datos personales ni tratamiento de esos datos por parte de un modelo de IA de terceros. El sistema se diseñó para el RGPD, cuyas multas llegan al 4% de la facturación anual. Este enfoque abre los grandes modelos de lenguaje (LLM) a ámbitos donde antes estaban vetados: sanidad, derecho, finanzas y RR. HH. Es justo el tipo de solución que diseñamos dentro de nuestro servicio de integración de IA, y la propia plataforma sigue el método del desarrollo de SaaS a medida.

Preguntas frecuentes

¿Cuánto se tarda en crear una plataforma para una agencia de traducción?

El núcleo (flujo por etapas, roles y espacio del traductor) tarda 2–3 meses en entrar en producción. Después, la plataforma crece en iteraciones semanales con versiones en producción: el cliente ve el avance en pantallas que funcionan, no en informes.

¿Los datos van a OpenAI o a Anthropic?

Solo el texto anonimizado: los nombres, números y direcciones se sustituyen por máscaras en el servidor del cliente antes de cualquier llamada a la nube. La tabla de correspondencias está cifrada y nunca se envía fuera. Así no hay transferencia internacional de datos personales ni tratamiento de esos datos por parte de un modelo de IA de terceros, lo que despeja la principal duda en materia de protección de datos. También hay un modo sin IA y un interruptor de «la nube no guarda nada».

¿Cuánto cuesta una plataforma así?

El precio depende del número de usuarios, de lo profunda que sea la capa de IA y de los requisitos de protección de datos, así que no existe una tarifa única que sea honesta. En la primera llamada calculamos gratis una horquilla orientativa: nos explicas tu proceso y te llevas un esquema de la arquitectura y un presupuesto aproximado.

¿De quién es el código y quién mantiene el sistema tras el lanzamiento?

El código fuente, los datos y la documentación son del cliente: por contrato le entregamos el repositorio completo. El soporte es opcional: nuestro equipo puede seguir desarrollando el sistema por iteraciones o traspasarlo a tus desarrolladores.

¿Por qué no un SaaS ya hecho como memoQ, Phrase o Smartcat?

Si tu proceso es estándar, un servicio ya hecho es más rápido y más barato, y te lo diremos en la primera llamada. Una plataforma a medida gana cuando importan a la vez la propiedad de los datos, unas reglas de precios poco habituales, los requisitos del sector público y una IA bajo tu control. Aquí se daban las cuatro cosas.

¿Necesitas un sistema así para tu proceso?

Diseñamos y desarrollamos plataformas sectoriales con capa de IA de principio a fin, desde el análisis del proceso hasta el lanzamiento y el soporte. Déjanos tu solicitud abajo: en una llamada de 30 minutos te enseñamos una demo en vivo de Polyglot y te esbozamos gratis la arquitectura y una horquilla de presupuesto para tu caso. Si un SaaS ya hecho cubre tu proceso, te lo diremos sin rodeos.
Tecnologías del proyecto

Python 3.12FastAPISQLAlchemy 2PostgreSQL 16React 18TypeScriptTanStack QueryTailwindClaude / OpenAI APIMicrosoft PresidioSSEDocker ComposeCaddyWireGuardASiC-E (firma electrónica)

Escríbenos directamente

Escríbenos: te respondemos en un día laborable y te ayudamos a concretar el proyecto.

Si nos contactas por mensajería o por correo electrónico, decides compartir tus datos de contacto para que respondamos a tu consulta. Tienes los detalles en nuestra Política de privacidad.